
مدل Claude Opus 5.5 چیست و چه جایگاهی دارد؟
شرکت آنتروپیک در تاریخ ۲۲ سپتامبر ۲۰۲۶ (۳۱ شهریور ۱۴۰۵) از جدیدترین پرچمدار خود پرده برداشت: مدل Claude Opus 5.5. این مدل به عنوان مغز متفکر نسل ۵.۵ معرفی شده و تمرکز اصلی آن روی استدلالهای عمیق، پروژههای طولانی و مهندسی نرمافزار به صورت عاملمحور (Agentic) است. نکته شگفتانگیز این رونمایی، شکست دادن پرچمدار جدید اوپنایآی یعنی GPT-6 Astra در آزمونهای مهم برنامهنویسی است؛ آن هم در شرایطی که هزینه استفاده از این مدل نسبت به نسلهای قبلی به شکل چشمگیری کاهش پیدا کرده است.
آنتروپیک خانواده مدلهای خود را بر اساس وزن و توان پردازشی به سه دسته Haiku (سریع و ارزان)، Sonnet (متعادل و کاربردی) و Opus (قدرتمندترین و عمیقترین) تقسیم میکند. مدل Claude Opus 5.5 اولین عضو از موج جدید ۵.۵ است که وارد میدان میشود. بر خلاف نسخههای قبلی که بیشتر بر تولید پاسخهای متنی تمرکز داشتند، این نسخه برای هدایت ابزارهای توسعه، اجرای دستورات پیچیده در خط فرمان و کار با ایجنتهای نرمافزاری بهینهسازی شده است.
این مدل از یک پنجره زمینه (Context Window) یک میلیون توکنی پشتیبانی میکند و سرعت پردازش و تولید متن در آن بیش از ۳۰ درصد نسبت به Opus 5 افزایش یافته است. وقتی با کدهای حجیم چند دههزار خطی سر و کار دارید، سرعت بالای تحلیل کل مخزن کد و درک معماری پروژه تفاوت بزرگی در تجربه کاری روزمره رقم میزند.
بنچمارکهای Claude Opus 5.5؛ مقایسه قدرت با Fable 5.1 و GPT-6
بر اساس گزارش رسمی شرکت Anthropic، مدل Opus 5.5 توانسته است در بیشتر آزمونهای معتبر مهندسی نرمافزار، استدلال و کارهای دانشمحور نه تنها نسل قبلی خود، بلکه پرچمدار گرانقیمت Fable 5.1 و حتی رقیب سرسخت خود، GPT-6 Astra را پشت سر بگذارد.
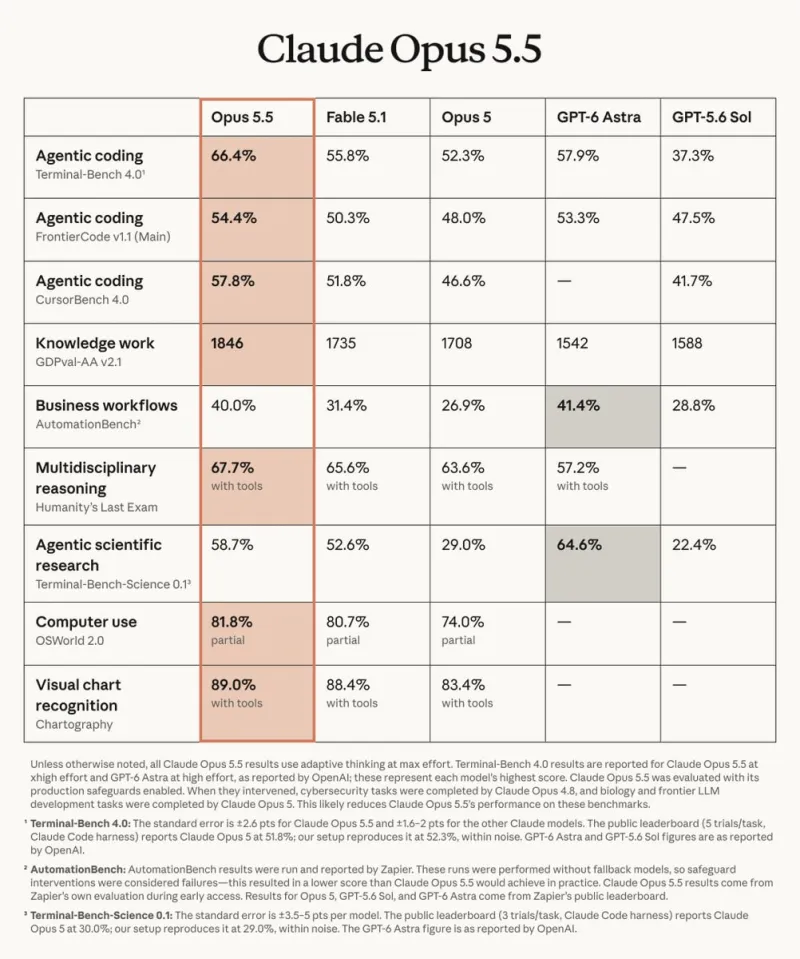
بزرگترین پیروزی این مدل در بنچمارک معتبر Terminal-Bench 4.0 ثبت شده است. این آزمون توانایی مدل را در حل مسائل واقعی برنامهنویسی درون محیط شبیهسازیشدهی ترمینال ارزیابی میکند. Opus 5.5 با کسب امتیاز ۶۶٫۴٪ با اختلاف آشکار از GPT-6 Astra (با امتیاز ۵۷٫۹٪) و Fable 5.1 (با امتیاز ۵۵٫۸٪) پیشی گرفته است.
| شاخص ارزیابی (Benchmark) | Claude Opus 5.5 | Claude Fable 5.1 | Claude Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| کدنویسی در ترمینال (Terminal-Bench 4.0) | ۶۶٫۴٪ | ۵۵٫۸٪ | ۵۲٫۳٪ | ۵۷٫۹٪ |
| حل مسائل پیشرفته کدنویسی (FrontierCode v1.1) | ۵۴٫۴٪ | ۵۰٫۳٪ | ۴۸٫۰٪ | ۵۳٫۳٪ |
| توسعه نرمافزار با ادیتور (CursorBench 4.0) | ۵۷٫۸٪ | ۵۱٫۸٪ | ۴۶٫۶٪ | تستنشده |
| کارهای تخصصی و دانشمحور (GDPval-AA v2.1) | ۱۸۴۶ | ۱۷۳۵ | ۱۷۰۸ | ۱۵۴۲ |
| استدلال چندرشتهای (Humanity’s Last Exam) | ۶۷٫۷٪ | ۶۵٫۶٪ | ۶۳٫۶٪ | ۵۷٫۲٪ |
| اتوماسیون گردش کار تجاری (AutomationBench) | ۴۰٫۰٪ | ۳۱٫۴٪ | ۲۶٫۹٪ | ۴۱٫۴٪ |
| تحقیقات علمی عاملمحور (Terminal-Bench-Science) | ۵۸٫۷٪ | ۵۲٫۶٪ | ۲۹٫۰٪ | ۶۴٫۶٪ |
| استفاده از سیستمعامل و نرمافزارها (OSWorld 2.0) | ۸۱٫۸٪ | ۸۰٫۷٪ | ۷۴٫۰٪ | تستنشده |
همانطور که در ارقام جدول بالا مشاهده میکنید، اگرچه اوپنایآی در مقاله آپدیت GPT-6 Astra نشان داد که در اتوماسیون امور تجاری و استدلال علمی دست بالا را دارد، اما آنتروپیک با Opus 5.5 جایگاه برتر خود را در برنامهنویسی و کارهای پیچیده دانشمحور با اقتدار تثبیت کرده است.
مقایسه قیمت و ارزش خرید؛ مقایسه با Fable 5.1 و Opus 5
در مدلهای بزرگ هوش مصنوعی، معمولاً ارتقای هوشمندی با افزایش سرسامآور قیمت همراه بود. اما آنتروپیک در نسخه ۵.۵ معادله را تغییر داده است. نکته برجسته اینجاست که Opus 5.5 عملکردی در سطح مدل تحقیقاتی Fable 5.1 یا فراتر از آن ارائه میدهد، در حالی که قیمت آن ۶۰ درصد ارزانتر است.
| مدل آنتروپیک | ورودی (هر ۱M توکن) | خروجی (هر ۱M توکن) | خواندن از کش (Cache Reads) | نسبت قیمت به نسخه جدید |
|---|---|---|---|---|
| Claude Fable 5.1 | ۱۰ دلار | ۵۰ دلار | ۰٫۲۵ دلار | گرانترین مدل تحقیقاتی |
| Claude Opus 5 | ۵ دلار | ۲۵ دلار | ۰٫۵۰ دلار | نسل قبلی |
| Claude Opus 5.5 | ۴ دلار | ۲۰ دلار | ۰٫۲۰ دلار | ۴۰٪ ارزانتر از Opus 5 و ۶۰٪ ارزانتر از Fable |
کاهش قیمت توکن ورودی به ۴ دلار و خروجی به ۲۰ دلار، هزینه اجرای ایجنتهای خودمختار را بسیار منطقی میکند. علاوه بر این، نرخ بازخوانی از کش (Prompt Caching) با قیمت فوقالعاده ارزان ۰٫۲۰ دلار در هر یک میلیون توکن فعال شده است. این یعنی اگر بخش عمدهای از پرامپت شما (مثل کل یک مخزن کد یا راهنمای مستندات سیستم) در حافظه کش بماند، هزینه درخواستهای بعدی تا ۹۰ درصد کاهش پیدا میکند.
تفکر انطباقی (Adaptive Thinking) و پارامتر effort
یکی از تغییرات ساختاری در Claude Opus 5.5، فعال بودن دائمی قابلیت تفکر انطباقی (Adaptive Thinking) است. در گذشته کاربر میتوانست ویژگی فکر کردن عمیق را خاموش یا روشن کند. در Opus 5.5 امکان خاموش کردن تفکر وجود ندارد؛ اگر تلاش کنید آن را خاموش کنید با پیام خطا روبرو میشوید.
به جای خاموش کردن، آنتروپیک پارامتری به نام effort معرفی کرده است که عمق تلاش فکری مدل را کنترل میکند:
- حالت Low (تلاش سبک): مدل زمان و توکن کمتری برای بررسی گزینهها صرف میکند و پاسخی سریع با حداقل هزینه تحویل میدهد؛ مناسب برای پرسشهای ساده و کارهای روتین.
- حالت Medium (پیشفرض): تعادلی عالی بین دقت، سرعت و مصرف توکن ایجاد میکند و برای بیشتر کارهای برنامهنویسی و تحلیلی پیشنهاد میشود.
- حالت Max (حداکثر توان): مدل تمام سناریوها را موشکافی میکند تا پیچیدهترین مسائل الگوریتمی، باگهای ساختاری پنهان و محاسبات منطقی را حل کند. تمام امتیازهای درخشان بنچمارکها در این حالت به دست آمدهاند.
همچنین آنتروپیک در این بهروزرسانی به بازخوردهای جامعه کاربران توجه کرده و سبک پاسخدهی مدل را بهبود داده است. در مدلهای قبلی، خروجی گاهی بیش از حد طولانی و همراه با جملات فرمولی و کلیشهای (معروف به لحن Claudish) بود. در Opus 5.5 لحن مدل بسیار طبیعیتر و صریحتر شده است و مستقیم سراغ پاسخ نهایی میرود.
سؤالات پرتکرار
آیا مدل Claude Opus 5.5 قویتر از Fable 5.1 است؟
بله، در اکثر آزمونهای تخصصی بهویژه برنامهنویسی عاملمحور در ترمینال (امتیاز ۶۶٫۴٪ در برابر ۵۵٫۸٪) و کارهای دانشمحور (امتیاز ۱۸۴۶ در برابر ۱۷۳۵)، مدل Opus 5.5 از Fable 5.1 عملکرد بهتری نشان داده و در عین حال ۶۰ درصد ارزانتر است.
تفاوت قیمت Claude Opus 5.5 با مدل قبلی Opus 5 چقدر است؟
مدل Opus 5.5 حدود ۴۰ درصد ارزانتر از Opus 5 است. نرخ توکنهای ورودی از ۵ دلار به ۴ دلار و نرخ توکنهای خروجی از ۲۵ دلار به ۲۰ دلار به ازای هر یک میلیون توکن کاهش پیدا کرده است.
پارامتر effort در مدل جدید چه نقشی دارد؟
از آنجا که تفکر انطباقی در این مدل همواره فعال است، با تنظیم پارامتر effort بین سه حالت Low، Medium و Max میتوانید عمق استدلال مدل، سرعت پاسخدهی و هزینه مصرف توکن را به دلخواه خود مدیریت کنید.
در مقایسه میان Claude Opus 5.5 و GPT-6 Astra کدام مدل برای برنامهنویسی برتر است؟
طبق بنچمارکهای رسمی مانند Terminal-Bench 4.0 و FrontierCode، مدل Opus 5.5 در حل چالشهای برنامهنویسی، خطایابی چندمرحلهای و تعامل با خط فرمان نسبت به GPT-6 Astra دست برتر را دارد.